tanai

वही अंग्रेज़ी, अलग मूड

रिव्यू और CV अंग्रेज़ी में ही रहेंगे।

CV ↓
मैं ही हूँ .AI

लैब

यहाँ मैं लिखता हूँ कि AI के साथ क्या बना रहा हूँ। कुछ रोज़ चलता है। कुछ एक स्केच है जिससे मेरी अभी बहस चल रही है। हर कार्ड बताता है कि कौन क्या है।

  • लाइव
  • पायलट
  • डिज़ाइन तैयार
  • कॉन्सेप्ट
  • बन रहा है
सिम्युलेटर →

सिम्युलेटर ठीक नीचे है। चलिए, इसे तोड़कर दिखाइए।

आज़माइए · लाइव

ऑर्डर फ़्लो सिम्युलेटर

एक ऑर्डर बनाइए, डिलीवरी का तरीक़ा और भुगतान की शर्तें चुनिए, और देखिए वह कहाँ जाता है, कब शिप होता है और इनवॉइस कब निकलता है। यह BrandHub (नए टैब में खुलेगा) के ऑर्डर नियमों पर चलता है। इसे तोड़कर दिखाइए।

सिम्युलेटर खोलिए →

Ask BrandHub

बन रहा है

पहले

मंथली रिपोर्ट, जिन्हें पढ़ने में बनाने से ज़्यादा समय लगता है।

कैसे

BrandHub (नए टैब में खुलेगा) के अपने सर्वर पर एक लोकल Llama मॉडल। इसे पूरा डेटाबेस नहीं मिलता। इसे PostgreSQL से क्वेरी करने के टूल मिलते हैं और पता होता है कि कौन सी टेबल में क्या है, इसलिए यह सीधे शब्दों में जवाब देता है।

मेरी भूमिका

मैं इसे बना रहा हूँ: यह कौन-से टूल इस्तेमाल कर सकता है, कौन-सी टेबल पढ़ सकता है, और इसके जवाबों की जाँच।

  1. सवाल
  2. Llama क्वेरी चुनता है
  3. PostgreSQL
  4. डेटा वापस
  5. सीधा जवाब

"पिछले महीने किन टेनेंट्स ने नैपकिन ऑर्डर किए?"

→ पहले प्रोडक्ट ढूँढता है

→ फिर टेनेंट्स, फिर उनके ऑर्डर
Claude स्किल्स और एजेंट्स

लाइव

पहले

एक स्प्रिंट तैयार करने में लगभग 20 घंटे, और हर हफ़्ते वही काम।

कैसे

Claude स्किल्स और एजेंट्स की एक चेन, जो मैंने अपने ही काम के धीमे हिस्सों के लिए बनाई: कॉम्पिटिटर रिसर्च, git और डेटा मॉडल पर असर, क्लाइंट डॉक्यूमेंट की सफ़ाई, Jira स्टोरी के ड्राफ़्ट। Atlassian Rovo हर स्टोरी में कमियाँ चेक करता है। अगर आपके हफ़्ते में भी ऐसा कोई हिस्सा है, या कोई पोर्टल फ़्लो जो आसान हो सकता है, तो वह मेरी तरह की समस्या है।

स्प्रिंट की तैयारी लगभग 20 घंटे से घटकर लगभग 6 रह गई।

मेरी भूमिका

मैंने इन्हें बनाया है, और हर स्प्रिंट में इनका इस्तेमाल करता हूँ।

  1. क्लाइंट डॉक्यूमेंट
  2. रिसर्च एजेंट
  3. इम्पैक्ट एजेंट
  4. स्टोरी ड्राफ़्ट
  5. Rovo चेक
  6. Jira

स्प्रिंट तैयारी .... 20 घंटे → लगभग 6 घंटे

सेल्स कॉल से कोटेशन

डिज़ाइन तैयार

पहले

आज एक कॉल में 10 से 15 मिनट लगते हैं: नोट्स लिखना, कैटलॉग खोजना और हाथ से ऑर्डर बनाना।

कैसे

BrandHub (नए टैब में खुलेगा) के लिए बनाया: AI ऑर्डर कॉल को पकड़ता है और ऑर्डर लाइनों का ड्राफ़्ट बनाता है। कॉल अंग्रेज़ी या डच में होती हैं। यह सेल्स टीम का एडमिन कम करता है। उनकी जगह नहीं लेता।

मेरी भूमिका

मैंने BrandHub (नए टैब में खुलेगा) के लिए फ़्लो डिज़ाइन किया और स्पेक लिखा।

  1. कॉल
  2. लाइव ट्रांसक्रिप्ट
  3. मॉडल प्रोडक्ट और मात्रा निकालता है
  4. कैटलॉग से मिलान
  5. ड्राफ़्ट ऑर्डर
  6. सेल्स टीम चेक करती है
  7. कोटेशन

"मुझे 500 नैपकिन चाहिए।"

→ प्रोडक्ट: नैपकिन, मात्रा: 500

→ 50 मिलते-जुलते नैपकिन, सेल्स टीम के चुनने के लिए क्रम में।

लक्ष्य ........... 5 से 6 मिनट

शॉप असिस्टेंट

कॉन्सेप्ट

पहले

नए ग्राहक को हज़ारों प्रोडक्ट वाला कैटलॉग नहीं पता होता।

कैसे

असिस्टेंट पूछता है कि उनका बिज़नेस क्या है, कहाँ है, किस लिए चाहिए और कितना, फिर प्रोडक्ट सुझाता है।

मेरी भूमिका

मेरा कॉन्सेप्ट। अभी काग़ज़ पर।

  1. कौन सा बिज़नेस?
  2. कहाँ?
  3. किस लिए?
  4. कितने?
  5. कैटलॉग में खोज
  6. सुझाई गई टोकरी

रेस्टोरेंट खोलने वाले को एप्रन, नैपकिन, यूनिफ़ॉर्म और टेबल का सामान एक ही लिस्ट में मिलता है।

सप्लायर ओवर-डिलीवरी रडार

कॉन्सेप्ट

पहले

प्रिंटिंग मशीनें अक्सर कुछ ज़्यादा छाप देती हैं। 1,000 ऑर्डर कीजिए, 1,050 आते हैं, और सप्लायर 1,050 का बिल भेजता है।

कैसे

एक बार चलता है। वेयरहाउस हर डिब्बा स्कैन करता है, तो सिस्टम पैटर्न पकड़ सकता है: एक ही सप्लायर से, एक ही आइटम पर +7%, +8%, +6%। फिर यह प्रोडक्ट मैनेजमेंट को बताता है, जो डिफ़ॉल्ट मात्रा, टॉलरेंस, या सप्लायर से बातचीत बदल सकता है।

मेरी भूमिका

मेरा कॉन्सेप्ट। अभी काग़ज़ पर।

  1. डिब्बा स्कैन हुआ
  2. ऑर्डर लाइन से मिलाया
  3. फ़र्क़ दर्ज हुआ
  4. पैटर्न पकड़ा
  5. अलर्ट

सप्लायर X · आइटम Y

ऑर्डर 1 ............. +7%

ऑर्डर 2 ............. +8%

ऑर्डर 3 ............. +6%

→ "3 बार ज़्यादा डिलीवरी। देखें?"

Ask Metis

लाइव

पहले

रोज़ लगभग 30 रिपोर्ट, और उनमें से ज़्यादातर सवाल थे, बग नहीं।

कैसे

फ़ाइल 03 वाला इंसिडेंट असिस्टेंट। एक LLM हर रिपोर्ट को सिस्टम के डेटा मॉडल और git के कोड से मिलाकर देखता है, फिर छाँटता है: ऐसा सवाल जिसका यह जवाब दे सके, असली बग, या बैकलॉग के लिए आइडिया।

मेरी भूमिका

मैंने इसे स्पेसिफ़ाई किया, प्रॉम्प्ट और आउटपुट के नियम लिखे, और लॉन्च की अगुवाई की।

  1. रिपोर्ट
  2. डेटा मॉडल + git
  3. सवाल / बग / आइडिया
  4. जवाब या Jira

इनवॉइसिंग प्लेटफ़ॉर्म

बन रहा है

पहले

टीमें अपने असली सिस्टम के साथ Teamleader और Moneybird जैसे इनवॉइसिंग टूल भी संभालती रहती हैं।

कैसे

मैनुअल और सिस्टम से बने इनवॉइस के लिए एक प्लेटफ़ॉर्म, शुरू से आख़िर तक।

मेरी भूमिका

मैं इसके OKR तय करता हूँ और बैकलॉग की प्राथमिकता तय करता हूँ, अपने चार प्रोडक्ट वाले पोर्टफ़ोलियो के हिस्से के तौर पर।

  1. ऑर्डर या मैनुअल
  2. ड्राफ़्ट
  3. रिव्यू
  4. बुक्ड

बन रहा है · 2026

Ask BrandHubबन रहा है

पहले

मंथली रिपोर्ट, जिन्हें पढ़ने में बनाने से ज़्यादा समय लगता है।

कैसे

BrandHub (नए टैब में खुलेगा) के अपने सर्वर पर एक लोकल Llama मॉडल। इसे पूरा डेटाबेस नहीं मिलता। इसे PostgreSQL से क्वेरी करने के टूल मिलते हैं और पता होता है कि कौन सी टेबल में क्या है, इसलिए यह सीधे शब्दों में जवाब देता है।

मेरी भूमिका

मैं इसे बना रहा हूँ: यह कौन-से टूल इस्तेमाल कर सकता है, कौन-सी टेबल पढ़ सकता है, और इसके जवाबों की जाँच।

  1. सवाल
  2. Llama क्वेरी चुनता है
  3. PostgreSQL
  4. डेटा वापस
  5. सीधा जवाब

"पिछले महीने किन टेनेंट्स ने नैपकिन ऑर्डर किए?"

→ पहले प्रोडक्ट ढूँढता है

→ फिर टेनेंट्स, फिर उनके ऑर्डर
Claude स्किल्स और एजेंट्सलाइव

पहले

एक स्प्रिंट तैयार करने में लगभग 20 घंटे, और हर हफ़्ते वही काम।

कैसे

Claude स्किल्स और एजेंट्स की एक चेन, जो मैंने अपने ही काम के धीमे हिस्सों के लिए बनाई: कॉम्पिटिटर रिसर्च, git और डेटा मॉडल पर असर, क्लाइंट डॉक्यूमेंट की सफ़ाई, Jira स्टोरी के ड्राफ़्ट। Atlassian Rovo हर स्टोरी में कमियाँ चेक करता है। अगर आपके हफ़्ते में भी ऐसा कोई हिस्सा है, या कोई पोर्टल फ़्लो जो आसान हो सकता है, तो वह मेरी तरह की समस्या है।

स्प्रिंट की तैयारी लगभग 20 घंटे से घटकर लगभग 6 रह गई।

मेरी भूमिका

मैंने इन्हें बनाया है, और हर स्प्रिंट में इनका इस्तेमाल करता हूँ।

  1. क्लाइंट डॉक्यूमेंट
  2. रिसर्च एजेंट
  3. इम्पैक्ट एजेंट
  4. स्टोरी ड्राफ़्ट
  5. Rovo चेक
  6. Jira

स्प्रिंट तैयारी .... 20 घंटे → लगभग 6 घंटे

सेल्स कॉल से कोटेशनडिज़ाइन तैयार

पहले

आज एक कॉल में 10 से 15 मिनट लगते हैं: नोट्स लिखना, कैटलॉग खोजना और हाथ से ऑर्डर बनाना।

कैसे

BrandHub (नए टैब में खुलेगा) के लिए बनाया: AI ऑर्डर कॉल को पकड़ता है और ऑर्डर लाइनों का ड्राफ़्ट बनाता है। कॉल अंग्रेज़ी या डच में होती हैं। यह सेल्स टीम का एडमिन कम करता है। उनकी जगह नहीं लेता।

मेरी भूमिका

मैंने BrandHub (नए टैब में खुलेगा) के लिए फ़्लो डिज़ाइन किया और स्पेक लिखा।

  1. कॉल
  2. लाइव ट्रांसक्रिप्ट
  3. मॉडल प्रोडक्ट और मात्रा निकालता है
  4. कैटलॉग से मिलान
  5. ड्राफ़्ट ऑर्डर
  6. सेल्स टीम चेक करती है
  7. कोटेशन

"मुझे 500 नैपकिन चाहिए।"

→ प्रोडक्ट: नैपकिन, मात्रा: 500

→ 50 मिलते-जुलते नैपकिन, सेल्स टीम के चुनने के लिए क्रम में।

लक्ष्य ........... 5 से 6 मिनट

शॉप असिस्टेंटकॉन्सेप्ट

पहले

नए ग्राहक को हज़ारों प्रोडक्ट वाला कैटलॉग नहीं पता होता।

कैसे

असिस्टेंट पूछता है कि उनका बिज़नेस क्या है, कहाँ है, किस लिए चाहिए और कितना, फिर प्रोडक्ट सुझाता है।

मेरी भूमिका

मेरा कॉन्सेप्ट। अभी काग़ज़ पर।

  1. कौन सा बिज़नेस?
  2. कहाँ?
  3. किस लिए?
  4. कितने?
  5. कैटलॉग में खोज
  6. सुझाई गई टोकरी

रेस्टोरेंट खोलने वाले को एप्रन, नैपकिन, यूनिफ़ॉर्म और टेबल का सामान एक ही लिस्ट में मिलता है।

सप्लायर ओवर-डिलीवरी रडारकॉन्सेप्ट

पहले

प्रिंटिंग मशीनें अक्सर कुछ ज़्यादा छाप देती हैं। 1,000 ऑर्डर कीजिए, 1,050 आते हैं, और सप्लायर 1,050 का बिल भेजता है।

कैसे

एक बार चलता है। वेयरहाउस हर डिब्बा स्कैन करता है, तो सिस्टम पैटर्न पकड़ सकता है: एक ही सप्लायर से, एक ही आइटम पर +7%, +8%, +6%। फिर यह प्रोडक्ट मैनेजमेंट को बताता है, जो डिफ़ॉल्ट मात्रा, टॉलरेंस, या सप्लायर से बातचीत बदल सकता है।

मेरी भूमिका

मेरा कॉन्सेप्ट। अभी काग़ज़ पर।

  1. डिब्बा स्कैन हुआ
  2. ऑर्डर लाइन से मिलाया
  3. फ़र्क़ दर्ज हुआ
  4. पैटर्न पकड़ा
  5. अलर्ट

सप्लायर X · आइटम Y

ऑर्डर 1 ............. +7%

ऑर्डर 2 ............. +8%

ऑर्डर 3 ............. +6%

→ "3 बार ज़्यादा डिलीवरी। देखें?"

Ask Metisलाइव

पहले

रोज़ लगभग 30 रिपोर्ट, और उनमें से ज़्यादातर सवाल थे, बग नहीं।

कैसे

फ़ाइल 03 वाला इंसिडेंट असिस्टेंट। एक LLM हर रिपोर्ट को सिस्टम के डेटा मॉडल और git के कोड से मिलाकर देखता है, फिर छाँटता है: ऐसा सवाल जिसका यह जवाब दे सके, असली बग, या बैकलॉग के लिए आइडिया।

मेरी भूमिका

मैंने इसे स्पेसिफ़ाई किया, प्रॉम्प्ट और आउटपुट के नियम लिखे, और लॉन्च की अगुवाई की।

  1. रिपोर्ट
  2. डेटा मॉडल + git
  3. सवाल / बग / आइडिया
  4. जवाब या Jira
इनवॉइसिंग प्लेटफ़ॉर्मबन रहा है

पहले

टीमें अपने असली सिस्टम के साथ Teamleader और Moneybird जैसे इनवॉइसिंग टूल भी संभालती रहती हैं।

कैसे

मैनुअल और सिस्टम से बने इनवॉइस के लिए एक प्लेटफ़ॉर्म, शुरू से आख़िर तक।

मेरी भूमिका

मैं इसके OKR तय करता हूँ और बैकलॉग की प्राथमिकता तय करता हूँ, अपने चार प्रोडक्ट वाले पोर्टफ़ोलियो के हिस्से के तौर पर।

  1. ऑर्डर या मैनुअल
  2. ड्राफ़्ट
  3. रिव्यू
  4. बुक्ड

बन रहा है · 2026

Peirceबन रहा है

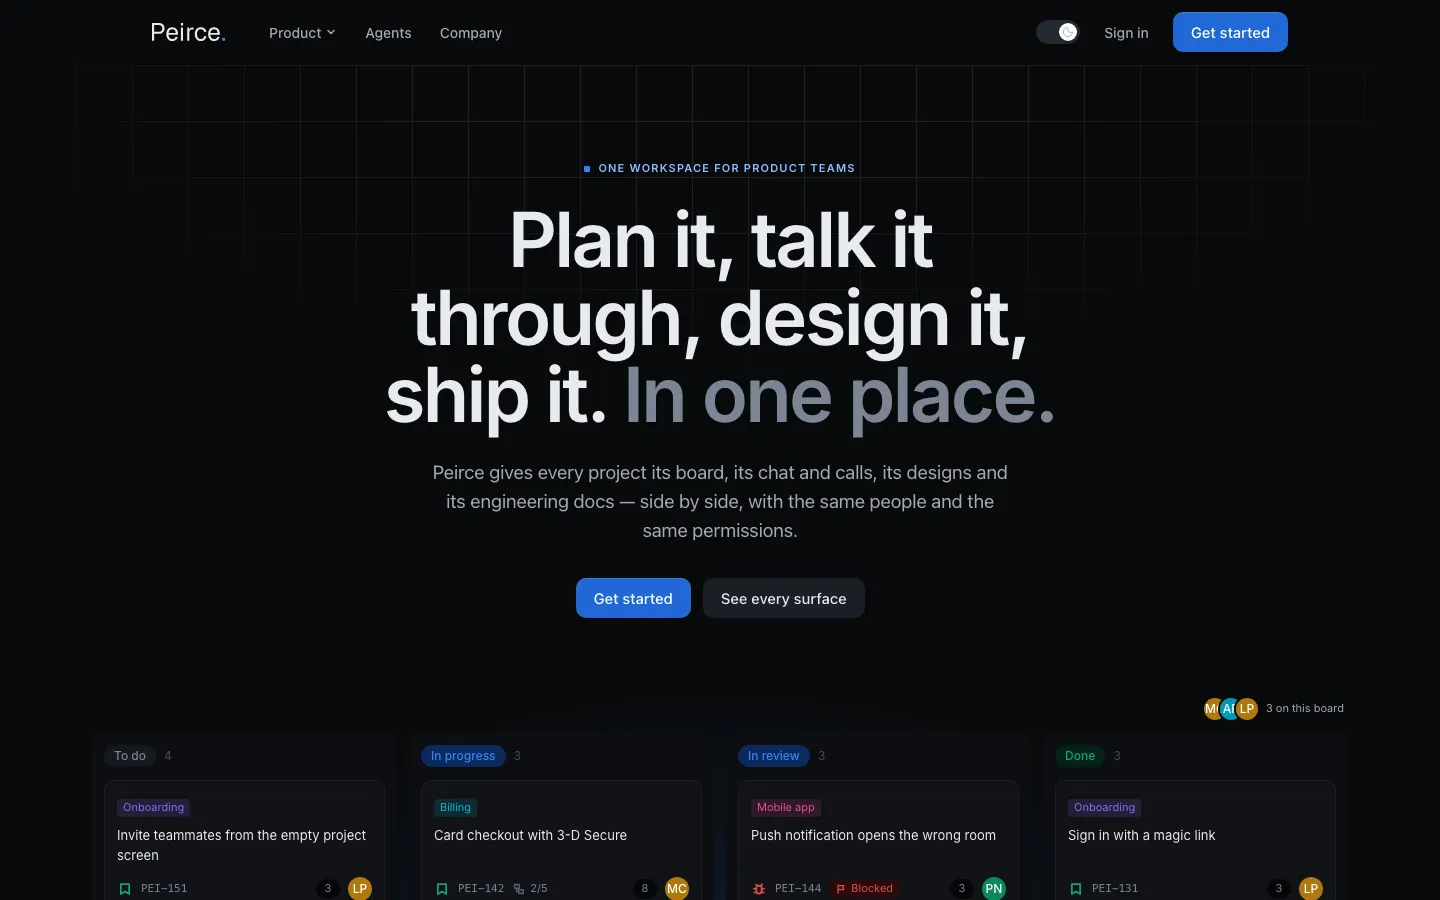
रिक्वायरमेंट, डिज़ाइन, डेटा मॉडल, बोर्ड, डॉक्स और चैट एक ही जगह, ताकि टीमों को Jira, Figma, Confluence और Teams के बीच भागना न पड़े। कुछ बदलता है तो AI ढूँढता है कि उससे और क्या प्रभावित होता है, और अपडेट करने में मदद करता है।

मेरी भूमिका

मेरा आइडिया। मैं इसे डिज़ाइन भी कर रहा हूँ और बना भी रहा हूँ।

प्रैग्मैटिज़्म के जनक के नाम पर। हम उसी को मानते हैं।

peirce.app →

Peirce बन रहा है

रिक्वायरमेंट, डिज़ाइन, डेटा मॉडल, बोर्ड, डॉक्स और चैट एक ही जगह, ताकि टीमों को Jira, Figma, Confluence और Teams के बीच भागना न पड़े। कुछ बदलता है तो AI ढूँढता है कि उससे और क्या प्रभावित होता है, और अपडेट करने में मदद करता है।

मेरी भूमिका

मेरा आइडिया। मैं इसे डिज़ाइन भी कर रहा हूँ और बना भी रहा हूँ।

प्रैग्मैटिज़्म के जनक के नाम पर। हम उसी को मानते हैं।

peirce.app →
Peirce का वर्कस्पेस, चैट और डॉक्स के बगल में एक बोर्ड
tan.ai से पूछिए